GPU- und KI-Server aus China
Wir bauen GPU-Knoten auf Dell R760xa, HPE DL380a, Lenovo SR675 V3 und xFusion-Chassis mit NVIDIA H100 NVL und H200, L40S für die Inferenz, RTX PRO 6000 und A100 für preisbewusste Konfigurationen. Luft- oder flüssigkeitsgekühlt, bis zu 8 Karten, mit der NVLink-, InfiniBand- und Leistungsreserve, die der Beschleuniger tatsächlich braucht.
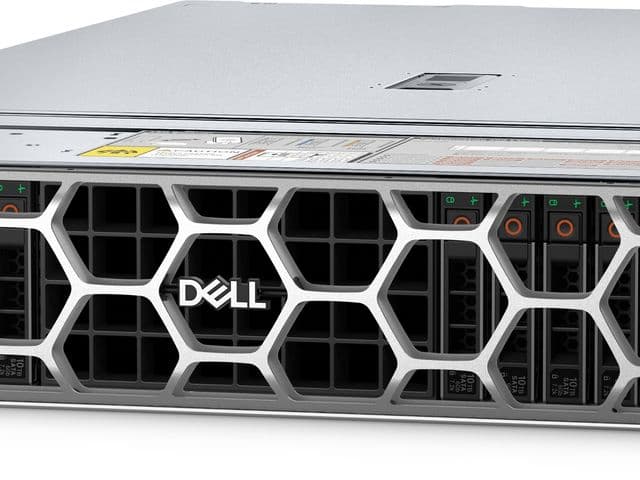
XE9785 liquid-cooled data center chassis.
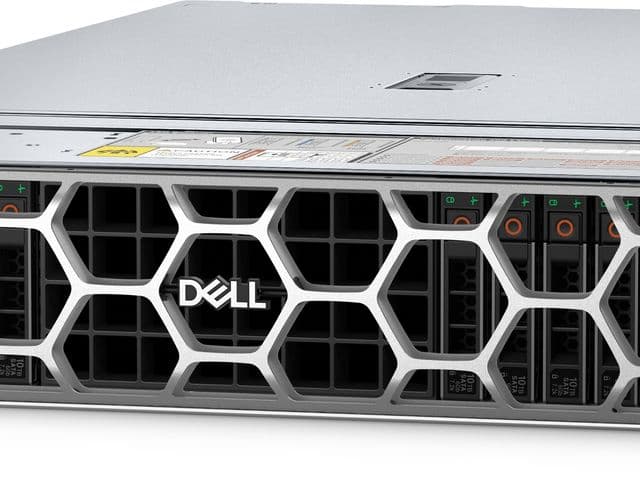
AI platform on AMD MI300X with DLC.
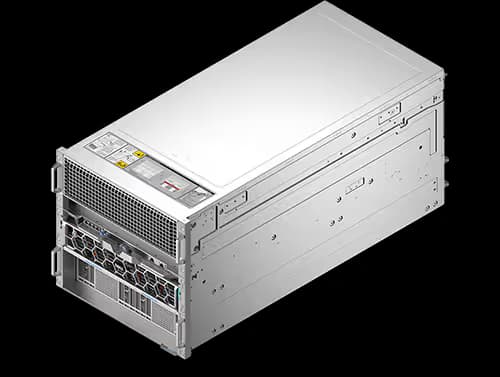
Extreme AI platform for LLM learning, DLC.
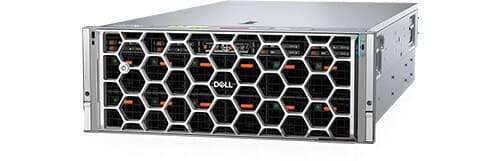
Advanced AI platform for LLM with 8 GPUs.
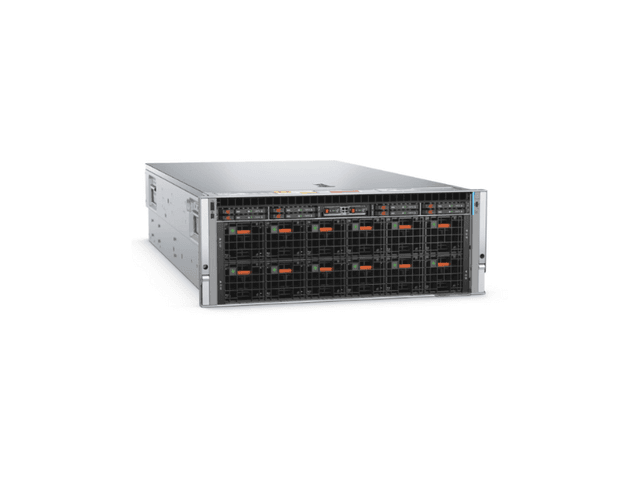
A next-generation server platform for LLM training.
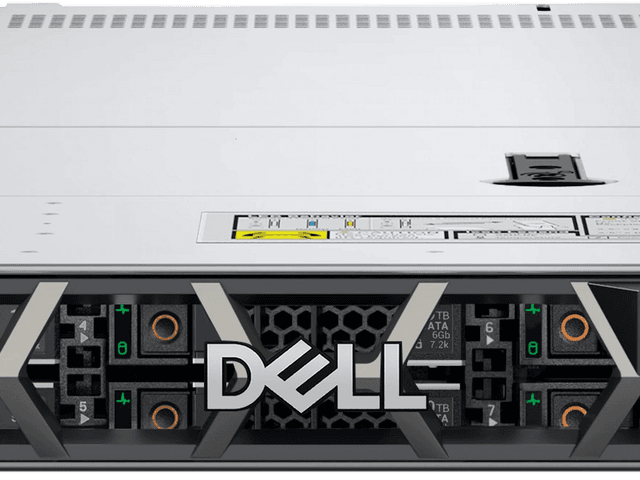
2U R770 for AI inference - up to 6 GPUs.
6U AMD MI300X liquid-cooled platform.
6U liquid cooling XE9680 for DLC data centers.
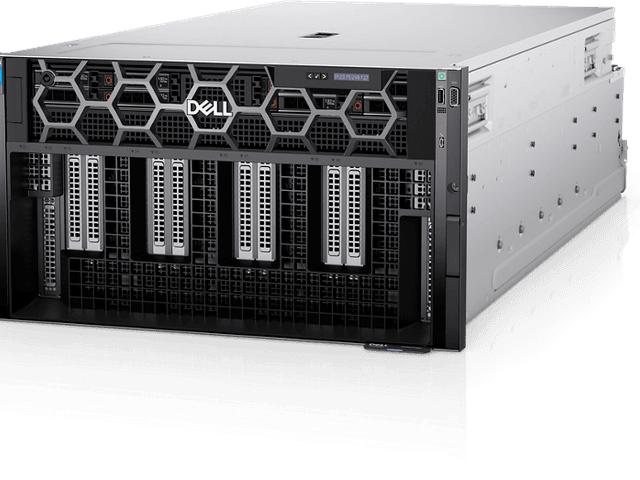
6U flagship for LLM education - 8× NVIDIA H100/H200.
2U liquid cooling with 4× NVIDIA H100.
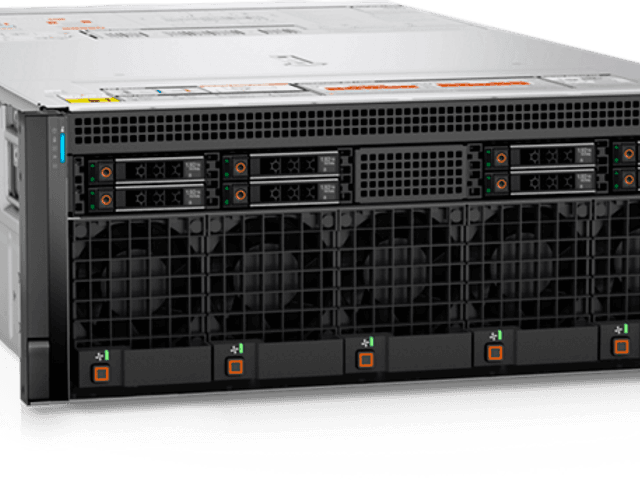
4U AI platform with 4× NVIDIA H100.
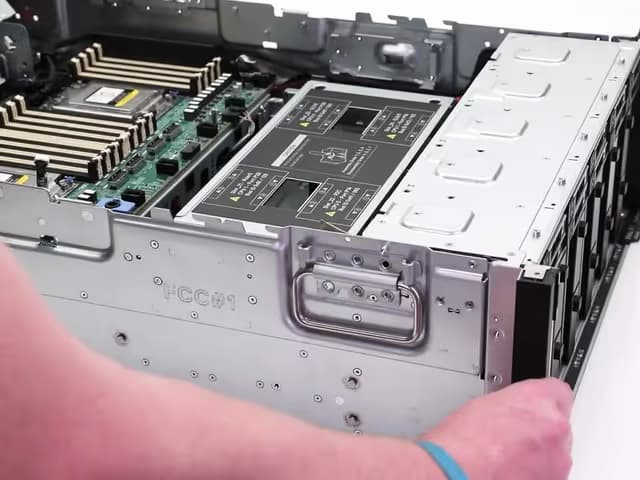
4U AI server with AMD EPYC + 4× NVIDIA A100.
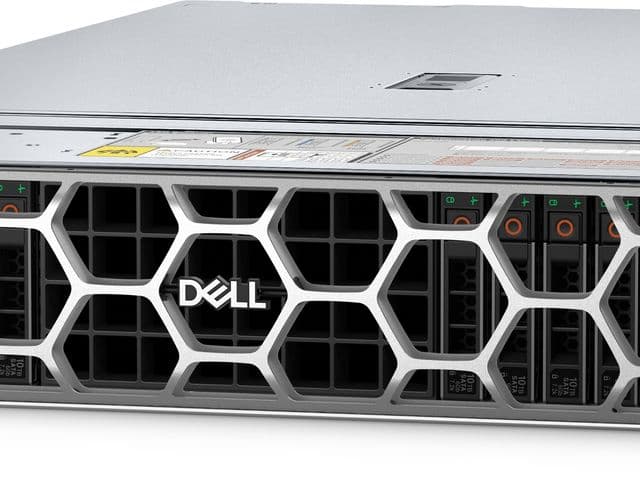
4U AI platform for distributed learning.
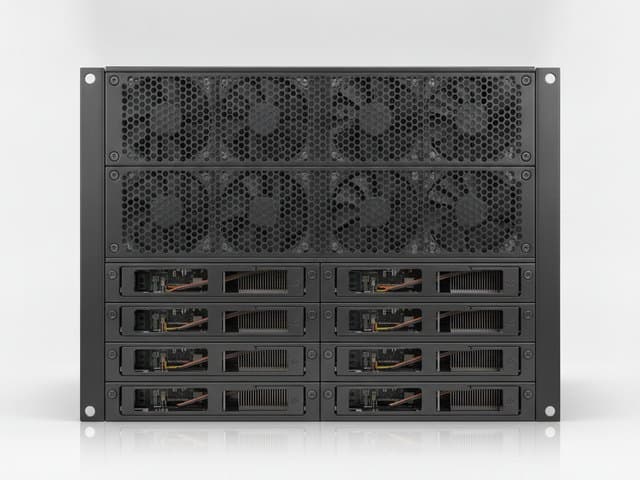
2U dedicated server for AI inference and analytics.
GPU-Plattformen für KI-Training und -Inferenz
Wir bauen GPU-Knoten auf Dell R760xa, HPE DL380a, Lenovo SR675 V3 und xFusion-Chassis mit NVIDIA H100 NVL und H200, L40S für die Inferenz, RTX PRO 6000 und A100 für preisbewusste Konfigurationen. Luft- oder flüssigkeitsgekühlt, bis zu 8 Karten, mit der NVLink-, InfiniBand- und Leistungsreserve, die der Beschleuniger tatsächlich braucht.
Jede Bestellung geht EXW Hangzhou raus, so sehen Sie einen sauberen Gerätepreis und behalten die Fracht in der Hand. Wenn Sie nicht selbst importieren möchten, organisieren wir einen Spediteur für DAP oder DDP in Ihre Stadt. Jedes Gerät wird 24 bis 72 Stunden eingebrannt und hat ein Jahr Garantie mit Vorabaustausch.